 Korea Job Guide
테크 기업 데이터 분석가 이직의 핵심은 윈도우 함수와 CTE를 활용한 복합 집계 SQL 역량, 비즈니스 지표 액션을 유도하는 대시보드 설계, '가설-데이터 추출-실험-비즈니스 임팩트' 구조의 포트폴리오입니다.
테크 기업 데이터 분석가 채용 시장의 현실과 실무 요구 조건
국내 데이터 직무 시장은 단순 도구 활용자보다 비즈니스 맥락을 이해하고 즉시 투입 가능한 경력 인재를 강하게 선호하고 있습니다. 과학기술정보통신부와 한국데이터산업진흥원이 발표한 2023 데이터산업 현황조사에 따르면, 데이터 직무 인력 채용 시 기업들의 경력직 선호 비중은 데이터산업 기준 60.6%, 전 산업 기준 67.1%에 달합니다1. 또한 인력 채용 시 겪는 주요 애로사항(복수응답)으로 데이터산업의 경우 '실무 역량을 갖춘 인력 부족'이 56.0%로 가장 높았고, '입사 부적응 및 조기 퇴사'가 54.9%, '채용에 따른 인건비 부담'이 47.4%로 뒤를 이었습니다1. 전 산업 기준 채용 애로사항에서도 '실무 역량을 갖춘 인력 부족'이 67.2%에 달해 가장 지배적인 문제로 조사되었습니다1.
이러한 현상은 테크 업계에서 데이터 분석가의 역할이 단순 지표 조회를 넘어 비즈니스 의사결정을 실질적으로 이끄는 직무로 자리 잡았음을 보여줍니다. 2023 데이터산업 현황조사 결과 향후 5년 내 전반적인 데이터 인력 대비 부족률은 12.6% 수준으로 집계되었으며, 현장에서는 이론 중심의 지원자보다 실전에 곧바로 투입 가능한 인재를 찾고 있습니다1. 일자리는 열려 있으나 기업이 요구하는 '실무 문제 해결 능력'과 지원자의 '이론 중심 준비' 사이에 구조적 격차가 존재하는 것입니다. 따라서 이직 준비는 단순 툴 학습에 그치지 않고, 테크 기업이 실무 평가에서 검증하는 구체적인 기술 기준에 맞추어야 합니다.
실무 SQL 역량과 코딩테스트 통과를 위한 핵심 점검표
한국산업인력공단 국가직무능력표준(NCS)의 빅데이터 분석(세분류 20010105) 직무 정의에 따르면, 빅데이터 분석은 다양한 형태의 대용량 데이터 집합으로부터 유용한 정보를 찾고 예측하기 위해 목적에 적합한 분석 기술과 방법을 적용하여 데이터에 대한 전처리, 탐색, 분석 모델링, 시각화를 수행하는 직무입니다2. 테크 기업 채용 실무에서 이러한 기초 역량을 1차로 검증하는 관문이 바로 SQL 코딩테스트입니다. 현업의 SQL 평가는 단순 테이블 조회가 아니라, 정규화되지 않은 유저 로그 테이블에서 복합적인 리텐션 지표와 코호트 분석을 단일 또는 연계 쿼리로 정확히 구현할 수 있는지를 확인합니다.
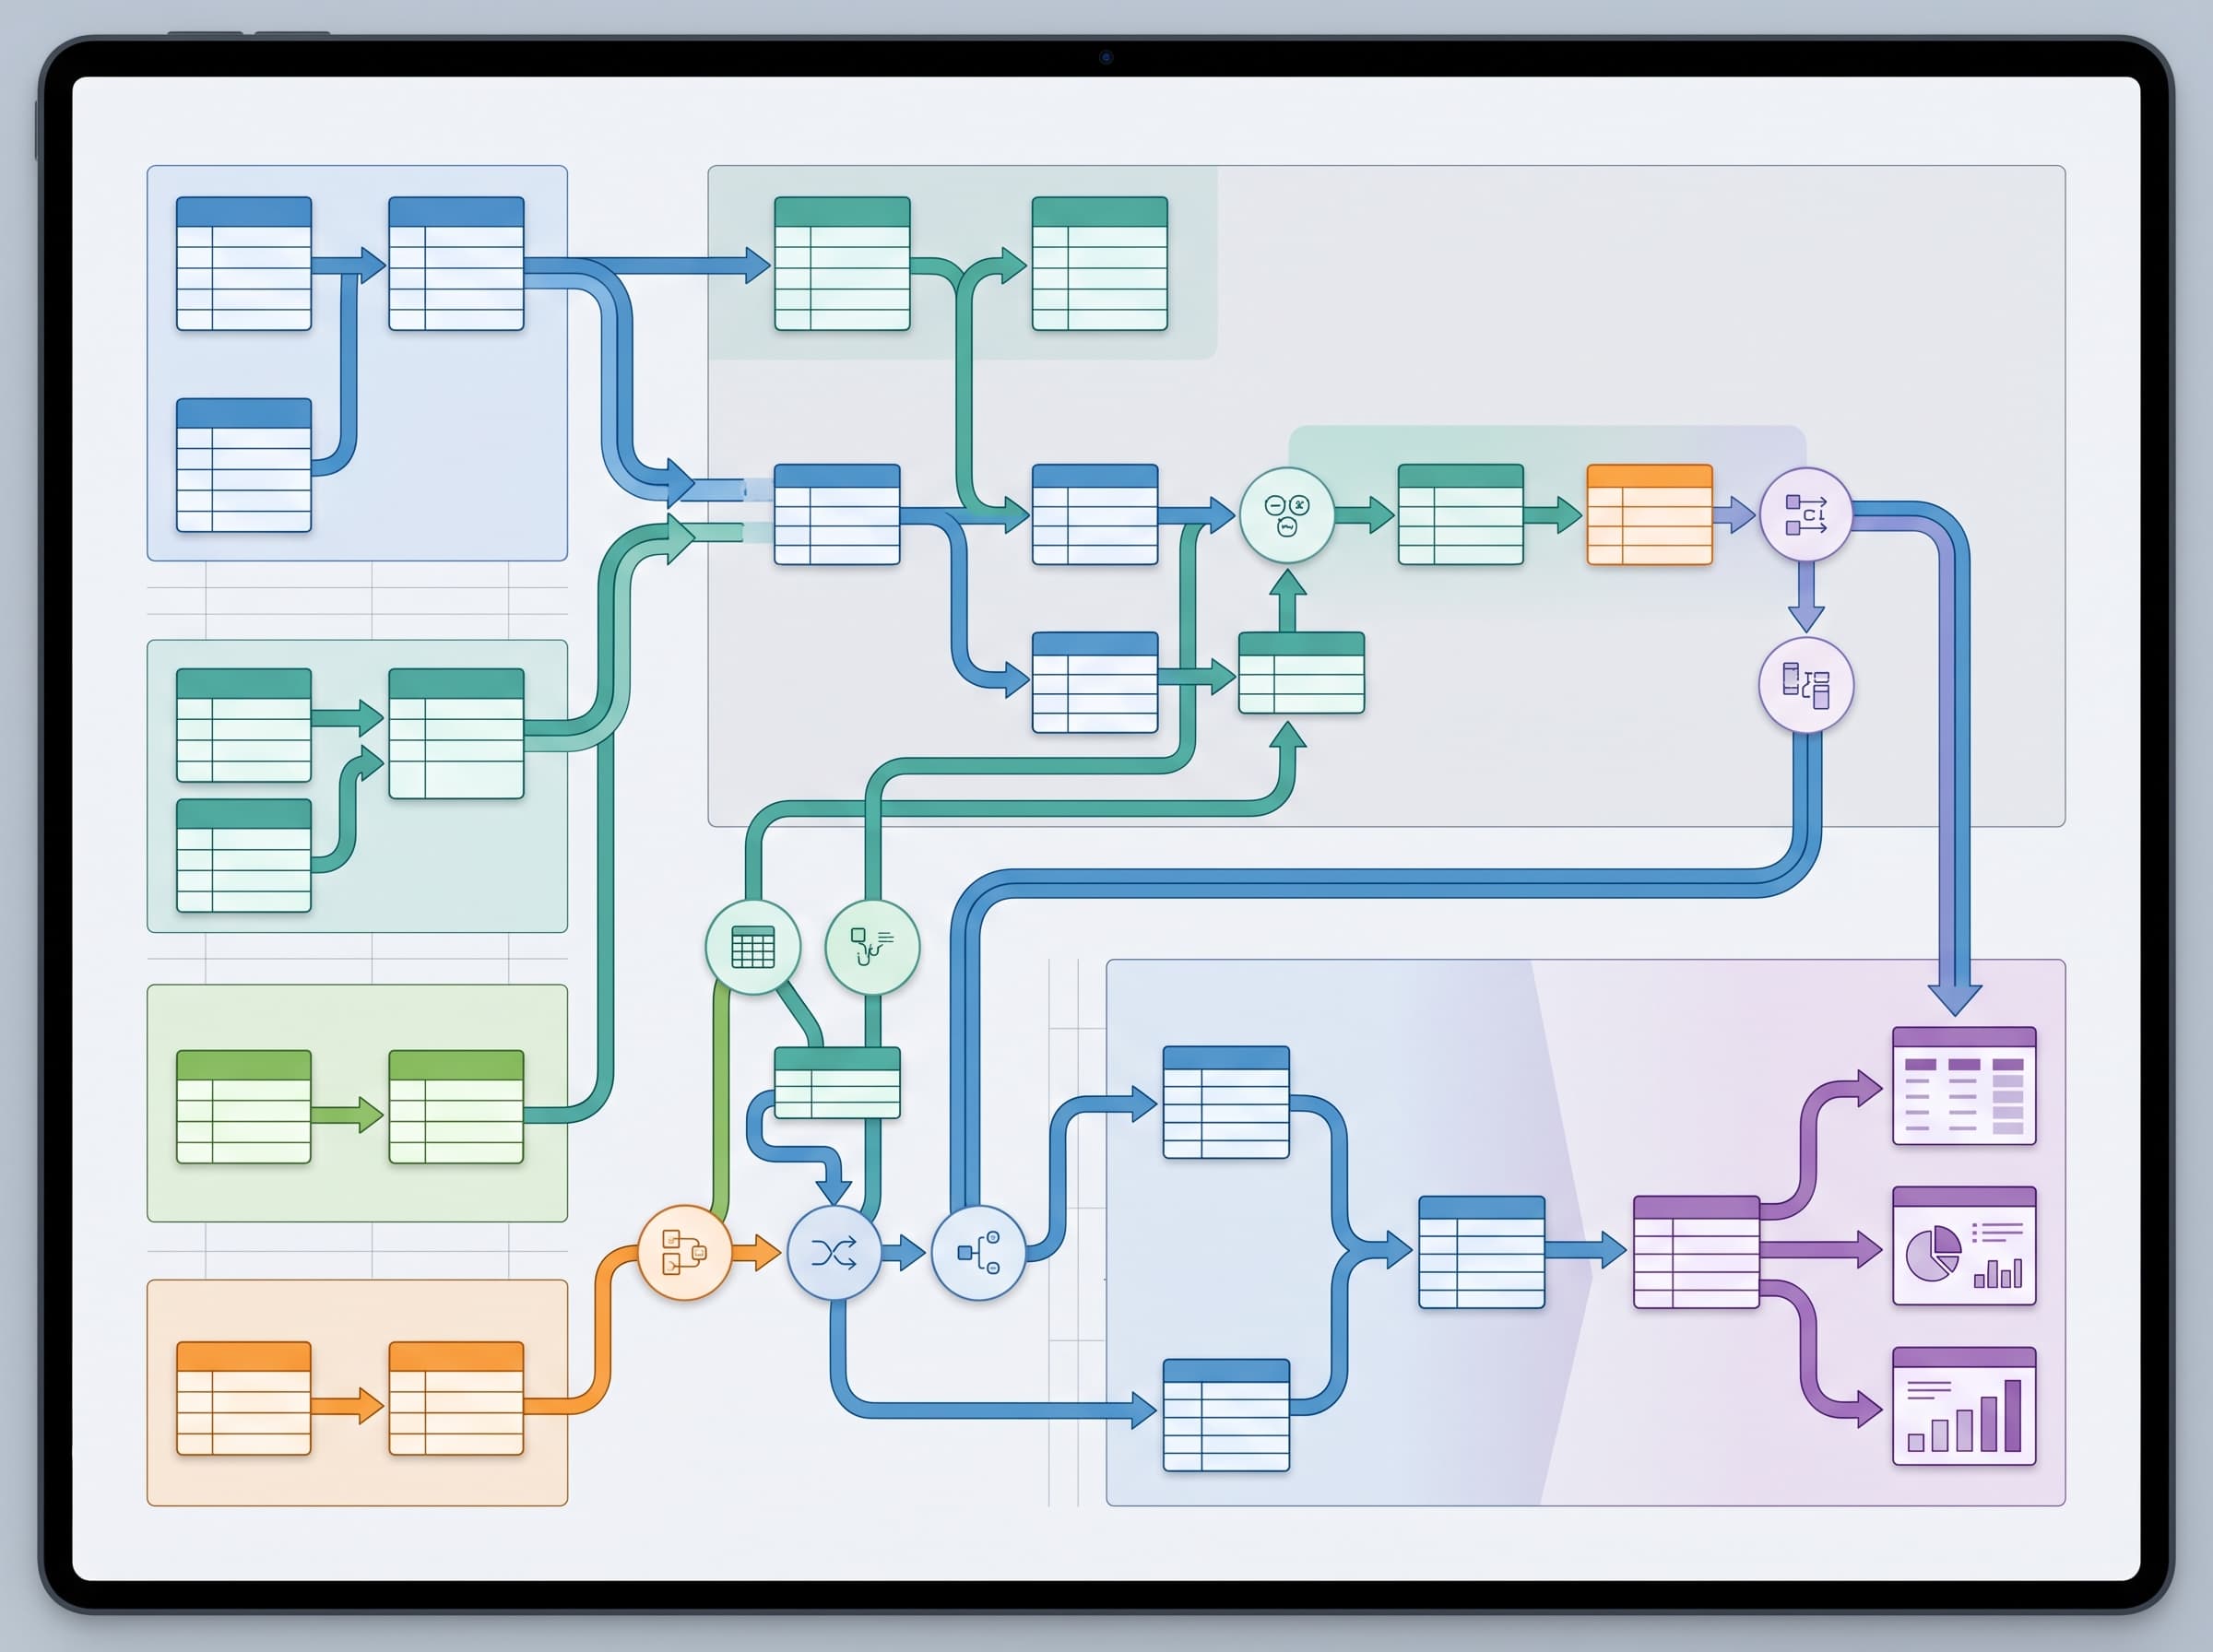
단순 SELECT-FROM-WHERE 구문이나 기본적인 GROUP BY 집계만으로는 테크 기업의 실무 코딩테스트를 통과하기 어렵습니다. 면접관과 테스트 설계자가 주목하는 주요 SQL 기술 요소는 CTE(Common Table Expressions, WITH 절)를 활용한 가독성 높은 쿼리 모듈화, 윈도우 함수(ROW_NUMBER, DENSE_RANK, LEAD, LAG)를 활용한 직전·직후 이벤트 간격 계산, 집계 함수와 프레임 절(ROWS BETWEEN)을 결합한 이동 평균 산출 등입니다. 대용량 분산 쿼리 환경(Presto, Trino, BigQuery)에서 파티션 필터링 조건을 생략해 무차별 풀스캔을 발생시키는 쿼리는 코딩테스트와 과제 전형 탈락의 직접적인 원인이 됩니다.
| 평가 영역 | 기초 수준 (Junior) | 실무 이직 수준 (Mid-level) | 탈락 요인 및 주의점 |
|---|---|---|---|
| 데이터 결합 | INNER / LEFT JOIN 기본 사용 | 비등가 조인, Self-JOIN, 세션 연속성 파악 조인 | 카티션 곱 발생으로 인한 쿼리 비용 폭증 |
| 윈도우 함수 | 기본 RANK 함수 단일 열 적용 | PARTITION BY 및 LEAD/LAG를 통한 코호트 잔존율 계산 | 프레임 기본값(RANGE) 이해 부족으로 인한 집계 오류 |
| 구조 최적화 | 중첩 서브쿼리 남발 | CTE(WITH 절) 기반 논리적 단계화 및 파티션 필터링 | 실행 계획을 무시한 인덱스 미적용 컬럼 연산 |
| 예외 처리 | 단순 WHERE IS NOT NULL | COALESCE, NULLIF를 활용한 0 나누기 방지 및 결측치 치환 | 집계 연산 시 NULL 전파 현상 간과 |
예쁜 차트를 넘어선 의사결정형 대시보드 구축 원칙
일반적으로 데이터 분석 및 빅데이터 직무는 실시간으로 쏟아지는 방대한 양의 데이터를 수집·저장·분석하여 의미 있는 분석 결과를 도출하고 의사결정 정보를 제공하는 역할로 통칭됩니다. 그러나 초보 분석가들이 가장 흔히 범하는 실수는 태블로(Tableau), 앰플리튜드(Amplitude), 메타베이스(Metabase) 등 도구의 복잡한 시각화 기법 자체에 매몰되어 실제 의사결정권자가 내려야 할 액션을 고려하지 못하는 점입니다.
실무에서 인정받는 대시보드는 현황만 단순히 나열하는 '상태 확인형(Status Monitoring)'이 아니라 즉각적인 액션을 촉발하는 '행동 유발형(Action-Driven)'이어야 합니다. 효과적인 대시보드는 정보 위계가 명확합니다. 최상단에는 북극성 지표(North Star Metric)와 전주/전월 대비 증감률(MoM, YoY)이 배치되어 이상 징후를 한눈에 파악할 수 있어야 합니다. 중간 단계에는 지표 변화의 원인을 유입 경로, 세그먼트, 고객 여정 단계별로 분해하여 보여주고, 하단에는 문제가 발생한 구체적인 유저 집단이나 거래 건을 필터링할 수 있는 테이블 뷰를 제공해야 합니다.
서류 합격률을 높이는 데이터 분석 포트폴리오 4단계 구조
많은 이직 지원자가 캐글(Kaggle)이나 공공데이터 포털에서 내려받은 정형 데이터를 머신러닝 모델에 단순히 학습시킨 타이타닉 생존자 예측 프로젝트를 포트폴리오로 제출합니다. 하지만 테크 기업 채용 담당자는 알고리즘 정확도 자체보다 프로덕트의 비즈니스 문제를 정의하고 해결한 구체적 맥락을 확인하고자 합니다. 데이터산업 기업의 56.0%가 채용 시 실무 역량을 갖춘 인력 부족을 호소하는 이유도 이처럼 실전 문제 해결 역량을 입증할 수 있는 지원자가 드물기 때문입니다1.
신뢰를 주는 데이터 분석 포트폴리오는 명확한 4단계 프레임워크를 갖추어야 합니다. 첫째, 비즈니스 문제 정의입니다. '왜 이 분석을 수행했는가?'에 대해 결제 퍼널 이탈률 급증이나 특정 코호트의 잔존율 하락 등 구체적인 배경을 제시합니다. 둘째, 가설 수립 및 탐색적 데이터 분석(EDA)입니다. 데이터의 결측치와 이상치를 정제하고 가설을 검증하기 위한 데이터 파이프라인을 설계합니다. 셋째, 실험 설계 및 해결안 도출입니다. A/B 테스트 지표 산출, 코호트 비교 등을 통해 유의미한 결론을 도출합니다. 넷째, 비즈니스 임팩트와 회고입니다. 분석 결과가 프로덕트 의사결정에 어떻게 기여했는지, 전환율 증가나 마케팅 비용 절감 추정치로 명시해야 합니다.
경력 이직 지원자를 위한 현실적인 전환 시나리오 및 조건별 준비법
지원자의 기존 직무 배경에 따라 이직 준비 전략은 명확히 구분되어야 합니다. 마케팅, 사업기획, 운영 등 비개발 직군에서 전환하는 지원자는 현업 도메인 지식과 비즈니스 감각이라는 강점을 갖추고 있습니다. 이 경우 무리하게 고난도 딥러닝 모델링에 매달리기보다는, 기존 업무에서 SQL을 도입해 반복 리포팅 업무를 자동화하거나 A/B 테스트 설계를 통해 마케팅 비용 효율을 개선한 실적을 정량화하여 포트폴리오의 전면에 내세워야 합니다.
반면 백엔드 개발자나 통계학 전공자처럼 기술적 기반이 탄탄한 지원자는 비즈니스 임팩트 전달력에 집중해야 합니다. 쿼리의 속도나 통계적 유의수준(p-value)만을 강조하면 비즈니스 맥락에 무관심한 엔지니어로 오해받기 쉽습니다. 데이터 수집부터 지표 정의, C레벨 보고용 시각화와 실제 프로덕트 기능 개선으로 이어진 연결 고리를 강조해야 합격 가능성을 극대화할 수 있습니다. 참고로 공공 직업정보 기준 빅데이터 및 데이터 직무 재직자의 평균연봉은 조사 시점과 산업군에 따른 차이가 있으며, 기업 규모, 재직자 경력 연차, 성과급 체계에 따라 편차가 크게 발생합니다.
기술 면접과 라이브 코딩테스트 대응 체크리스트
서류 전형을 통과한 뒤 마주하는 기술 면접에서는 작성한 포트폴리오를 기반으로 날카로운 검증 질문이 이어집니다. 주로 '이 지표를 왜 리텐션의 기준으로 정의했는가?', '대안으로 검토했던 보조 지표는 무엇이었는가?', '데이터 정합성(Data Integrity) 문제는 쿼리 수준에서 어떻게 사전에 검증했는가?'와 같은 실무 질문이 주어집니다. 따라서 포트폴리오에 기재한 모든 지표의 산출식과 데이터 정제 로직은 스스로 완벽히 설명할 수 있어야 합니다.
라이브 코딩 테스트에서는 정확한 SQL 문법 구사 못지않게 면접관과의 상호작용이 평가에 지대한 영향을 미칩니다. 문제를 받자마자 무작정 쿼리를 작성하지 말고, 데이터 스키마의 기본 키(PK) 조건, 결측치 유무, 일자별 중복 로그 처리 기준 등을 면접관에게 먼저 역질문하여 엣지 케이스를 확인해야 합니다. 쿼리를 작성하는 도중에도 자신이 왜 윈도우 함수를 선택했는지, 중간 집계 테이블 크기를 줄이기 위해 어떤 필터링을 선제 적용했는지를 구두로 설명하는 태도가 합격을 가르는 중요한 요소입니다.
자주 묻는 질문
Q. 비전공자도 부트캠프 수료만으로 테크 기업 데이터 분석가 이직이 가능한가요?
A. 단순 강의 수강이나 정형화된 수료 프로젝트만으로는 데이터산업 기준 60.6%에 달하는 경력직 선호 시장에서 합격하기 어렵습니다. 이전 직무의 도메인 지식과 결합하여 실제 비즈니스 문제를 해결한 데이터 포트폴리오를 증명해야 경쟁력을 갖출 수 있습니다.
Q. SQL 코딩테스트 준비 시 어떤 플랫폼과 함수를 중점적으로 연습해야 하나요?
A. 프로그래머스 고득점 Kit와 리트코드(LeetCode)의 Database 카테고리 문제를 활용하는 것이 좋습니다. 특히 ROW_NUMBER(), LEAD(), LAG() 같은 윈도우 함수와 WITH 절(CTE), 복합 JOIN 구문을 집중적으로 학습해야 합니다.
Q. 데이터 분석가 포트폴리오에 머신러닝 딥러닝 프로젝트도 반드시 포함해야 하나요?
A. 아닙니다. 프로덕트 데이터 분석가(Product Data Analyst)는 복잡한 딥러닝 모델링보다 정확한 지표 정의, 로그 데이터 전처리, 코호트 분석, A/B 테스트 실험 설계 및 의사결정 지원 역량을 훨씬 높게 평가합니다.
참고 자료
- 2023 데이터산업 현황조사 결과 발표과학기술정보통신부
- NCS 빅데이터 분석 - 국가직무능력표준한국산업인력공단